Mahoutでランダムフォレストを試してみた
「ビッグデータ」もう何度も耳にした用語ではないでしょうか?
では、具体的にどのように活用すれば良いのでしょう。
メディアプランの方法論で言えばDiscoveryやLook-alikeがありますが
とにかくデータに触れてみて、分析をしてみる事が新たな発見の近道だと思います。
ということでMahoutでRandom Forestを試してみました。
■環境
・Hadoop
・Pig
・Mahout-0.7
■Random Forestとは
多数の決定木を用いた集団学習により、他の分類(SVMなど)と比べ
高精度の分類・予測(回帰)を実現する機械学習アルゴリズム。
ようは多数の決定木を作成して、それぞれの決定木が出した答えを多数決して、
最も支持が多かったクラスに分類する手法です。
質問に「YES」か「NO」で答える診断テストが複数あって、その中で
1番多く当てはまった診断結果を最終の解にするイメージですかね。
「三人寄れば文殊の知恵」
■MahoutでRandom Forestを試してみる
Rのデータセットのirisを分類してみます。
データ:iris(アヤメのデータ)
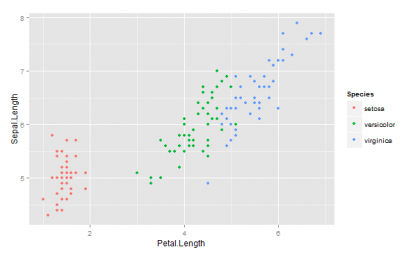 irisの散布図
| 説明変数 | 目的変数 | |||
|---|---|---|---|---|
| 花葉(長さ:幅) | 花びら(長さ:幅) | 種類 | ||
| Sepal.Length | Sepal.Width | Petal.Length | Petal.Width | Species |
| 5.1 | 3.5 | 1.4 | 0.2 | setosa |
| 6.5 | 3 | 5.5 | 1.8 | virginica |
| 5,2 | 3,3 | 3 | 1 | versicolor |
・Rで学習データとテストデータをランダムに抽出
data
・HDFSに登録
$hadoop fs -put iris.train iris_data
・データセット(説明ファイル)を作成する
$mahout org.apache.mahout.classifier.df.tools.Describe \
-p iris_data/iris_train \
-f iris_data/iris_train+.info \
-d 4 N L
※-dオプションは「Iが無視、Nが数値、Cがカテゴリ文字列、Lがラベル(目的変数)」
・モデルを作成する
$mahout org.apache.mahout.classifier.df.mapreduce.BuildForest \
-d iris_data/iris_train \
-ds iris_data/iris_train+.info \
-o decision_forest_iris \
-t 10 #ツリーの数
・モデルを評価する
$mahout org.apache.mahout.classifier.df.mapreduce.TestForest \
-i iris_data/iris_train \
-ds iris_data/iris_train+.info \
-m decision_forest_iris \
-a -mr -o test_iris_output
実行結果
Summary
-------------------------------------------------------
Correctly Classified Instances : 74 98.6667%
Incorrectly Classified Instances : 1 1.3333%
Total Classified Instances : 75
==================================================
Confusion Matrix
-------------------------------------------------------
a b c 25 1 0 | 26 a = virginica
0 24 0 | 24 b = versicolor
0 0 25 | 25 c = setosa
とりあえず、そのまま学習データで評価してみました。
当然ですが99%近い高いスコアで動作しています。
・Classifyしてみる
~Javaコード抜粋~
Configuration conf = new Configuration();
Path forestPath = new Path("decision_forest");//モデルのPath

// decisionForestを取得
DecisionForest decisinForest = DecisionForest.load(conf, forestPath);

// Datasetを取得
Dataset dataset = Dataset.read(datasetBinary);

// 本来はベクトルから取得するが、とりあえずiris.testからベタで記述
//String vector = "5.8,2.7,5.1,1.9,0"; //0 virginica
//String vector = "7,3.2,4.7,1.4,0"; // 1 versicolor
String vector = "5.1,3.5,1.4,0.2,0"; //2 setosa

DataConverter dataConverter = new DataConverter(dataset);
Instance instance = dataConverter.convert(vector);

Random random = new Random();

//Classifyを実施
double id = decisinForest.classify(dataset, random, instance);
log.debug("classify=============>" + id);
実行結果
classify=============>2.0
解答が2.0なので、正しくsetosaに分類されてますね。
今回はRのデータセットを利用したのでRでもRandomForestを実施してみます。
#RandomForestを生成(目的変数はSpecies)
forest
実行結果
pred.forest setosa versicolor virginica
setosa 25 0 0
versicolor 0 24 4
virginica 0 2 20
Rでも高い正解率ですね!
■まとめ
今回はiris(アヤメ)のデータで試してみましたが、例えばオーディエンスデータだと考えてみましょう。
オーディエンスデータは花びらと花葉の代わりにデモグラフィック(地域や性別など)や興味データの情報を持っています。
これを基に分析してみるとLook-alike(似た人を探す)などが実現できるのではないでしょうか。
他にも似た物同士のいくつかのグループに分けてみるなど、色々と分析できますね。
ちなみに色々と試してみるデータはオープンデータがお勧めです。
とにかくデータを分析してみましょう!